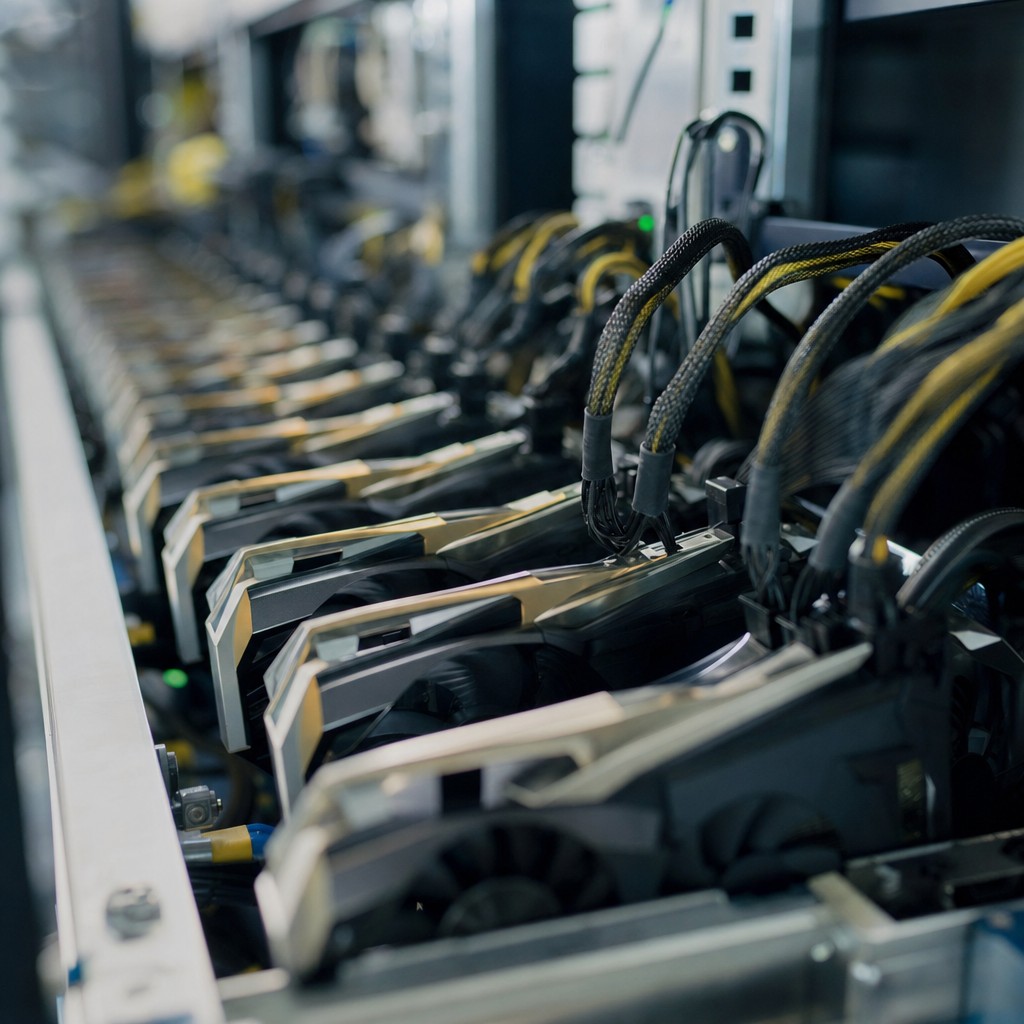
Grafikkortet tar över robotträningen – tusentals simuleringar körs nu parallellt
NVIDIAs nya ramverk låter 2 048 robotar träna samtidigt på ett enda grafikkort.

Flaskhalsen som ingen pratade om
Det finns en fråga som länge legat i bakgrunden när robotutvecklare diskuterat träningshastighet: Hur snabbt kan en enskild simulering köras? Men enligt Hugging Face-bloggen har den frågan i praktiken spelat ut sin roll. Den relevanta frågan idag är en annan – hur många simuleringar kan köras samtidigt?
Det är en subtil men avgörande förskjutning. Traditionell robotsimulering med det populära verktyget MuJoCo har förlitat sig på processorkraft, och visserligen kan arbete fördelas över flera processorkärnor. Men när datamängderna för modern maskininlärning växer, räcker det helt enkelt inte till. Varje träningssteg kräver miljontals erfarenheter, och att samla in dem en i taget – eller ens ett tiotal åt gången – skapar en trång passage som bromsar hela utvecklingen.
Grafikkortet tar över simuleringsrollen
Det är här NVIDIA:s Warp-ramverk kliver in. Warp är ett Python-baserat ramverk för högpresterande beräkning på grafikkort. Det som gör det särskilt intressant är att utvecklare skriver statiskt typade kärnor i vanlig Python-syntax, som sedan kompileras för CUDA-körning. Första gången en kärna startas kompileras och sparas koden – därefter återanvänds den direkt, utan overhead.
På toppen av Warp har NVIDIA byggt MuJoCo Warp, ofta förkortat MJWarp. Det tar befintliga MuJoCo-modeller – de fysiksimuleringar som robotforskare redan använder och litar på – och skalar upp dem till grafikkortskapacitet. Resultatet är slående: i det exempel som beskrivs i källartikeln kan man köra upp till 2 048 parallella simuleringsmiljöer för en robotarm av modellen SO-101, allt på ett enda grafikkort.
En central designprincip gör detta möjligt: varje logisk tråd hanterar exakt ett objekt – en punkt, en kontaktyta, en kropp eller en hel simulerad värld. Det innebär att tusentals simulerade robotar bokstavligen lever sina egna liv parallellt, samlar erfarenheter, misslyckas, justerar – och lär sig.
Vad det innebär i praktiken
För att förstå varför detta är betydelsefullt hjälper det att tänka på hur moderna robotar faktiskt lär sig. Förstärkningsinlärning – den metod som dominerar mycket av robotträningen idag – kräver enorma mängder återkoppling. En robot måste prova tusentals varianter av en rörelse, få återkoppling om vilka som fungerade, och iterera. Det är tidskrävande per definition.
När träning som tidigare tog dagar eller månader kan pressas ned till timmar, öppnar sig möjligheter som tidigare var opraktiska. Forskare kan testa fler hypoteser. Företag kan iterera snabbare. Och – kanske viktigast – tröskeln för att träna specialiserade robotar för smala tillämpningar sjunker markant.
Det är inte ett hypotetiskt löfte. Grafikkortsaccelererad simulering är ett mönster vi sett växa fram inom flera områden – från vätskesimulering i spelgrafik till beräkningskemi – och varje gång har hastighetsökningen möjliggjort kvalitativa språng, inte bara kvantitativa.
Öppet ekosystem som katalysator
En detalj som förtjänar uppmärksamhet: MJWarp bygger på befintliga MuJoCo-modeller, vilket innebär att den stora samlingen av redan skapade robotmodeller och forskningsmiljöer kan användas direkt. Det sänker inträdeskostnaden rejält. Forskargrupper och småbolag behöver inte bygga om från grunden – de kan ta sina befintliga simuleringar och skala upp dem.
Hugging Face:s engagemang i att sprida kunskapen om tekniken tyder också på att detta inte är en stängd NVIDIA-intern lösning, utan något som är tänkt att leva i ett bredare, öppet ekosystem. Det är en viktig signal för hur tekniken faktiskt kommer att spridas och användas.
Vår analys
Det som händer här är mer än en hastighetshöjning – det är en förändring av vad som överhuvudtaget är möjligt att träna. När experimentcyklar krymper från månader till timmar förändras hela forskningslogiken: fler idéer kan testas, fler misslyckanden kan tolereras, och specialiserade lösningar för smala industriella problem blir ekonomiskt rimliga att utveckla.
Jag ser detta som en del av ett större mönster där hårdvaruutveckling och mjukvaruarkitektur börjar mötas på ett sätt som gynnar AI-träning i grunden – inte bara för stora teknikjättar utan för hela ekosystemet av robotikforskare och startupbolag.
Den verkliga frågan framöver är inte om tekniken fungerar, utan vem som får tillgång till den. Grafikkortskapacitet är fortfarande en begränsande resurs. Men med molntjänster och sjunkande hårdvarupriser pekar riktningen mot demokratisering. Om den trenden håller i sig kan vi om några år se en robotikutveckling som påminner om hur språkmodeller exploderade när beräkningströsklarna sänktes.