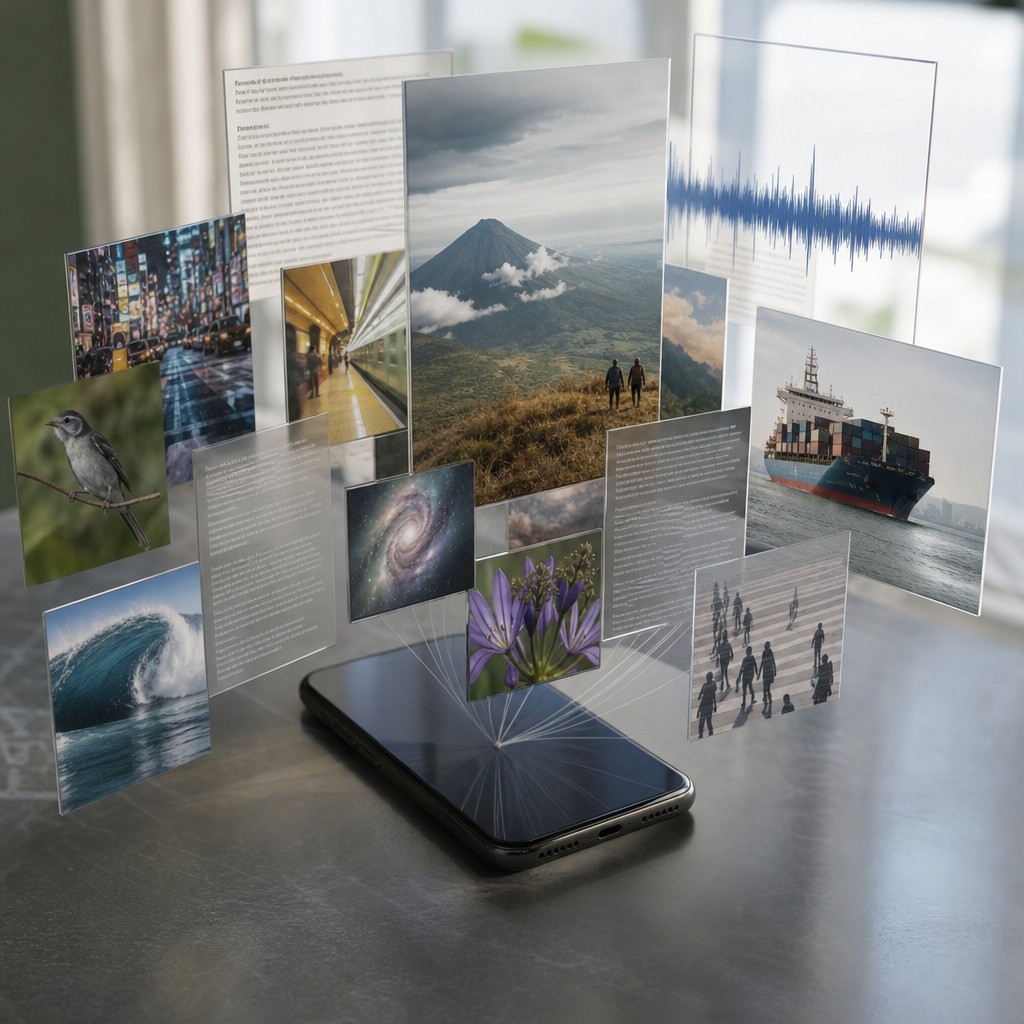
Googles nya inbäddningsmodell hanterar text, bild, video och ljud – och ryms i din telefon
Googles nya AI-modell förstår text, bild, video och ljud – och får plats i fickan.

En gemensam förståelse för allt
Föreställ dig att du söker i ett bildarkiv med en textfråga, eller att din app kan jämföra ett ljudklipp med en texbeskrivning – utan att du behöver bygga separata system för varje modalitet. Det är kärnlöftet bakom EmbeddingGemma 2, som Google DeepMind nyligen lanserade och som rapporteras av MarkTechPost.
Modellen är byggd på Gemma 4-arkitekturen och kan omvandla text, kod, bilder, video och ljud till en gemensam 768-dimensionell vektorrymd. Det tekniska innebörden är elegant: oavsett om indata är ett fotografi eller ett kodstycke, hamnar det i samma representationsformat, vilket gör det möjligt att jämföra och söka tvärs över modaliteter på ett naturligt sätt.
I praktiken är det just den förmågan som länge krävt dyra, komplexa pipeline-lösningar med separata specialmodeller för varje datatyp. Nu samlas det i ett paket.
Storleken spelar roll – åt rätt håll
Det som verkligen fångar min uppmärksamhet som utvecklare är de tekniska specifikationerna. Modellen är modulär och skalbar: enbart textanvändning kräver bara 270 miljoner parametrar, medan fullt multimodalt stöd går upp till 740 miljoner parametrar. Med kvantisering kräver textversionen ungefär 191 MB arbetsminne, och den fullständiga multimodala versionen runt 567 MB – detta mätt på en Pixel 11 Pro.
Det är siffror som faktiskt betyder något. Vi pratar om en modell som ryms i en modern telefons lediga minne utan att man behöver offra hela appupplevelsen. För den som har följt hur trenden gått mot allt tyngre modeller under de senaste åren är detta en välkommen rörelse i motsatt riktning.
Kontextfönstret på 8 192 symboler är dessutom fyra gånger större än föregångarmodellen, vilket i praktiken innebär att modellen kan hantera exempelvis 5,5 minuters ljud eller 29 bilder i ett enda anrop. Det öppnar för riktigt intressanta användningsfall inom sökning, klassificering och semantisk analys av längre innehåll.
Öppen källkod och ett välbekant ekosystem
En detalj som inte ska underskattas: modellen släpps under Apache 2.0-licensen och finns tillgänglig via Hugging Face och Kaggle. Den är kompatibel med verktyg som Ollama och llama.cpp – alltså precis det ekosystem som många självständiga utvecklare och mindre team redan använder.
Det är ett medvetet val av Google DeepMind. Att inte bara lansera en modell utan att möta utvecklare där de faktiskt befinner sig sänker tröskeln dramatiskt. Man behöver inte skriva om sin infrastruktur, man kan börja experimentera med befintliga verktyg.
Vad betyder det för apputvecklare?
I konkreta termer öppnar EmbeddingGemma 2 för flera typer av funktioner som tidigare var svåra att bygga utan molntjänster:
- Semantisk sökning tvärs över text och bilder i lokala databaser
- Innehållsklassificering av blandade medietyper direkt på enheten
- Likhetsanalys som kan jämföra ett ljudklipp mot en textbeskrivning
- Offlinekapabla AI-funktioner utan beroende av nätverksuppkoppling
Det sista punkten är kanske det mest underskattade. Integritetskänsliga tillämpningar – tänk hälsoapp, anteckningsverktyg, lokalt dokumentarkiv – kan nu dra nytta av multimodal AI utan att data någonsin lämnar enheten. Det är inte en liten sak.
Vi har sett en tydlig branschtrend mot det som ibland kallas edge AI, alltså AI som körs på själva enheten snarare än i ett datacenter. EmbeddingGemma 2 är ett tydligt steg i den riktningen, och den tekniska kvaliteten på implementationen ser lovande ut.
Som systemutvecklare ser jag det här som precis den sortens byggsten som saknats: en väldefinierad, öppen och tillräckligt liten modell som faktiskt kan inbäddas i en riktig produkt utan att kräva ett eget serverkluster.
Vår analys
EmbeddingGemma 2 är intressant av flera skäl samtidigt. Det är en tekniskt välgjord modell, men det verkliga genomslaget handlar om positionering: Google DeepMind skickar en tydlig signal om att framtidens AI-infrastruktur inte enbart ska leva i molnet.
Inbäddningsmodeller är ofta underskattat centrala i AI-system – de är det lager som avgör hur väl ett system förstår och jämför information. Att göra detta multimodalt och enhetsoptimerat i ett och samma paket sänker komplexiteten för utvecklare markant.
Utvecklingen pekar mot en framtid där AI-kapabiliteter inte är en molntjänst man prenumererar på, utan en komponent man bygger in lokalt. Det förändrar spelreglerna kring integritet, latens och kostnader. Om fler modeller följer samma filosofi – öppna, modulära, enhetsanpassade – kan vi förvänta oss en ny generation appar där AI är en naturlig del av produkten snarare än ett externt beroende. Det är en utveckling jag ser fram emot att följa noga.