Maten som får folk att tappa aptiten – forskning förklarar varför AI kämpar med nudlar, glass och burgare
Restaurangkedjor försökte spara på matbilder med AI – resultatet tappade kunderna aptiten.

Maskgalna nudlar och hjärnliknande glass
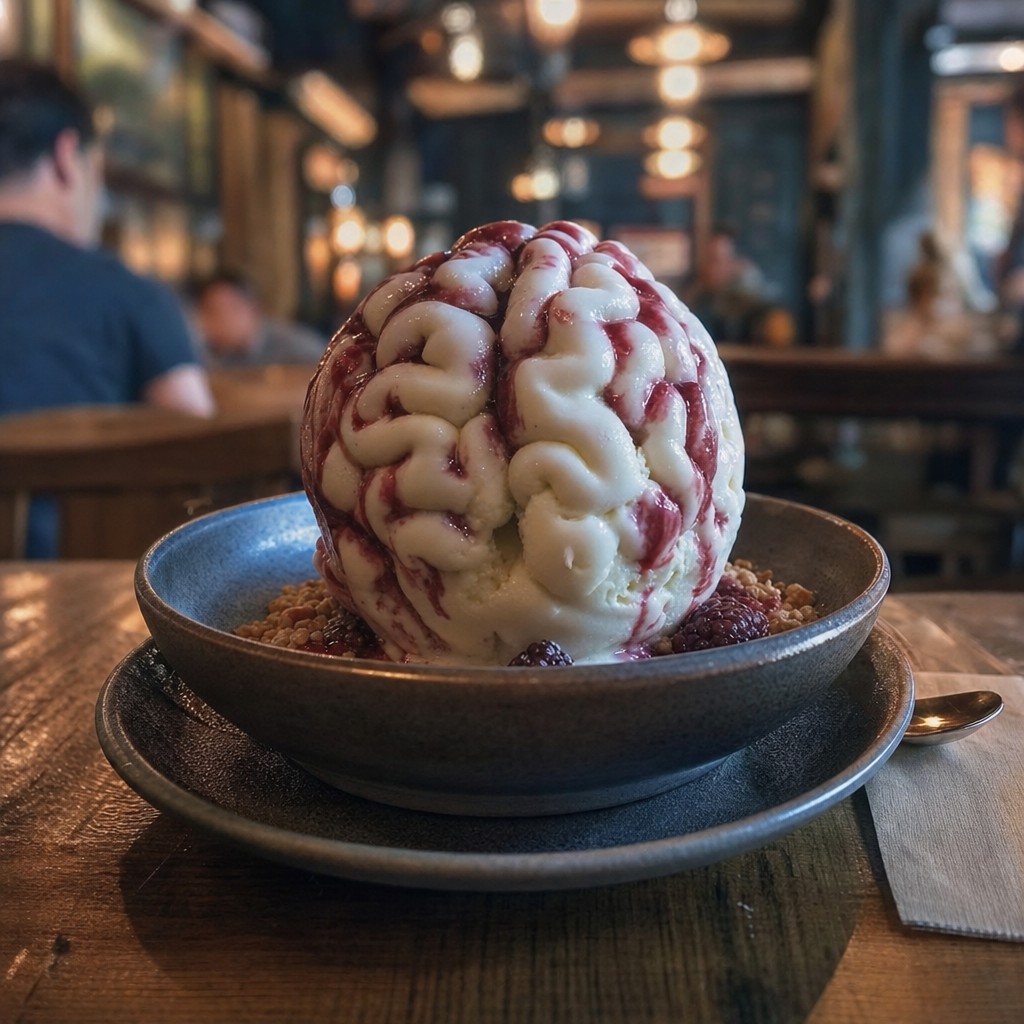
Det har blivit en genre i sig på sociala medier: skärmdumpar av uppenbart AI-genererade matbilder från restaurangers marknadsföring, ihopsamlade och hånfulla kommentarer inkluderade. En burgare med kött som flödar åt fel håll. En glasskula som ser ut som en tumör. Spaghetti som tycks ha ett eget liv.
Det roliga är att det inte rör sig om okända nystartade företag utan om etablerade varumärken som velat spara tid och pengar på bildproduktion. Resultatet har i många fall blivit det motsatta av avsett: viral uppmärksamhet, fast av fel sort.
Men bakom skratten finns en genuint intressant teknisk fråga: Varför är moderna bildsystem så förbluffande dåliga på just mat?
Bruset som aldrig riktigt försvinner
De flesta ledande system för bildgenerering bygger på så kallad diffusionsteknik. Processen börjar med en bild av rent brus – tänk gammaldags TV-brus – och rensar sedan successivt fram den önskade bilden, lager för lager. Grovare strukturer skapas först, finare detaljer läggs till mot slutet.
Detta låter elegant, och det är det också – i många sammanhang. Men som Chris Russell, professor i artificiell intelligens och datorsyn vid Oxfords universitet, förklarar för The Verge: om grundstrukturen är fel från allra första början läggs sedan detaljerna ovanpå en redan felaktig form. Felet förstärks snarare än korrigeras. Det är exakt samma mekanism som ligger bakom det klassiska AI-problemet med för många fingrar på händer.
Mat är ett extremfall av detta problem, av flera anledningar.
Nudlar, frön och geometrisk kaos
Beteendevetaren Giovanbattista Califano vid universitetet Federico II i Neapel pekar på att diffusionsmodeller är notoriskt svaga på tunna, sammanhängande strukturer. Nudlar, trådar, spiralformer – precis den geometri som återkommer i otaliga maträtter – är en sorts akilleshäl för tekniken.
Det handlar om hur modellerna är tränade. De har lärt sig att känna igen och återskapa mönster från enorma mängder bilder, men de har ingen egentlig förståelse för fysik eller materialegenskaper. En modell vet inte att nudlar hänger ihop, att smält ost sträcker sig på ett visst sätt, eller att ett halvätna äpple har en logisk relation till det som saknas.
Detta är en viktig distinktion: nuvarande bildgenereringsteknik är i grunden ett avancerat mönsterigenkänningssystem, inte ett system som förstår världen. Den kan producera något som liknar mat på ett statistiskt genomsnittligt sätt, men så fort detaljerna kräver sammanhang och logik – hur en bulle komprimeras mot ett fat, hur sauce rinner längs en specifik yta – tappar systemet greppet.
Varumärkena betalar priset
Det intressanta ur ett affärsperspektiv är att misstaget ofta är dubbelt kostsamt. Dels ser bilden dålig ut. Men dels sänder det en signal om slarv och bristande kvalitetsmedvetande – precis det motsatta av vad ett matmärke vill kommunicera.
Fotografi av mat är en konstform med decennier av raffinemang bakom sig. Ljussättning, rekvisita, styling, timing – allt samverkar för att framkalla en känsla av aptit och njutning. Det är ett område där det mänskliga omdömet fortfarande har ett tydligt övertag, inte minst för att vi som betraktare är exceptionellt bra på att känna igen när något inte ser rätt ut.
Det är faktiskt fascinerande: vi kan inte alltid sätta ord på varför en AI-genererad maträtt ser konstig ut, men vi märker det omedelbart. Vår hjärna har åratals träning på att bedöma mat – om den är säker att äta, om den är mogen, om den ser god ut. Det evolutionära arvet gör oss till mycket noggranna kritiker.
En teknik i utveckling – men inte färdig än
Det vore fel att dra slutsatsen att AI-genererade bilder aldrig duger. Tekniken är redan förvånansvärt kraftfull för abstrakta motiv, landskap, konceptuell grafik och varumärkesprofilering utan livsmedel i fokus. Och utvecklingen går snabbt – modellerna blir bättre för varje generation.
Men mat är ett av de hårdaste testfallen som finns, och det är lärorikt att studera exakt varför. Det avslöjar fundamentala begränsningar i hur diffusionsmodeller representerar världen: statistisk likhet är inte detsamma som förståelse.
Vår analys
Det som AI-genererade matkatastrofer egentligen illustrerar är ett gap som sällan diskuteras tillräckligt tydligt: skillnaden mellan att imitera och att förstå. Nuvarande bildgenereringsteknik är oerhört imponerande på det förra, men saknar helt det senare.
Detta är faktiskt ett värdefullt kalibreringsinstrument för hela branschen. Mat fungerar som ett slags stresstest – domänen kräver fysikalisk logik, rumslig konsekvens och en förståelse för materialegenskaper som dagens modeller inte besitter.
På sikt tror jag att vi kommer att se hybridlösningar: AI som hjälper till med konceptutveckling, bakgrunder och ljussättning, medan faktiska produkter fotas på traditionellt vis. Det är inte ett nederlag för tekniken – det är en realistisk arbetsfördelning baserad på vad varje metod faktiskt är bra på.
Det riktigt intressanta kommer när nästa generations modeller tränas med fysikalisk simulering snarare än enbart bilddata. Då förändras spelplanen.